Codificatore di entità HTML
E un decodificatore che perdona
Questo codificatore di entità HTML trasforma il testo in entità con nome, decimali o esadecimali, e poi di nuovo in testo. Per impostazione predefinita codifica i cinque caratteri che HTML riserva e, se lo chiedi, tutto ciò che è fuori dall’ASCII.
- GratisPrezzo
- 3Forme
- NessunaRegistrazione
- NessunaCaricamenti
Codificatore e decodificatore di entità HTML
Dal testo alle entità e ritorno, con le regole spiegate
- Caratteri in entrata
- 0
- Convertiti
- 0
- Caratteri in uscita
- 0
In HTML cinque caratteri vanno davvero codificati: la e commerciale, le due parentesi angolari e le due virgolette. Tutto il resto è una scelta di margini di sicurezza.
Pronto. Incolla qualcosa e la conversione avviene mentre scrivi.
Quali caratteri riserva HTML
Cinque caratteri significano qualcosa per un parser. La e commerciale apre un’entità, le due parentesi angolari aprono e chiudono un tag e, inoltre, le due virgolette chiudono il valore di un attributo.
Il resto rimane testo comune. Così una lettera accentata, una lineetta e un’emoji attraversano un documento UTF-8 senza modifiche.
Per questo la codifica è più ristretta di quanto si pensi. Nel testo te ne servono tre su cinque e, dentro un attributo, anche le virgolette corrispondenti.
L’elenco completo dei nomi si trova nello standard HTML e supera le duemila voci. Tuttavia quasi nessuna è necessaria.
Con nome, decimale o esadecimale
Le entità con nome si leggono bene, perché un ti dice cos’è. Invece un   ti dice solo un numero.

I numeri funzionano sempre. Ogni code point ne ha uno, non entra in gioco alcuna tabella e, di conseguenza, nulla dipende dal fatto che un parser conosca un nome.
L’esadecimale è lo stesso numero in base sedici. Usalo quando copi valori da una tabella Unicode, poiché le tabelle li stampano così.
Quando codificare tutto
Un documento servito come UTF-8 non ha bisogno di entità per gli accenti, poiché i caratteri sono semplicemente caratteri. Così il browser li legge correttamente.
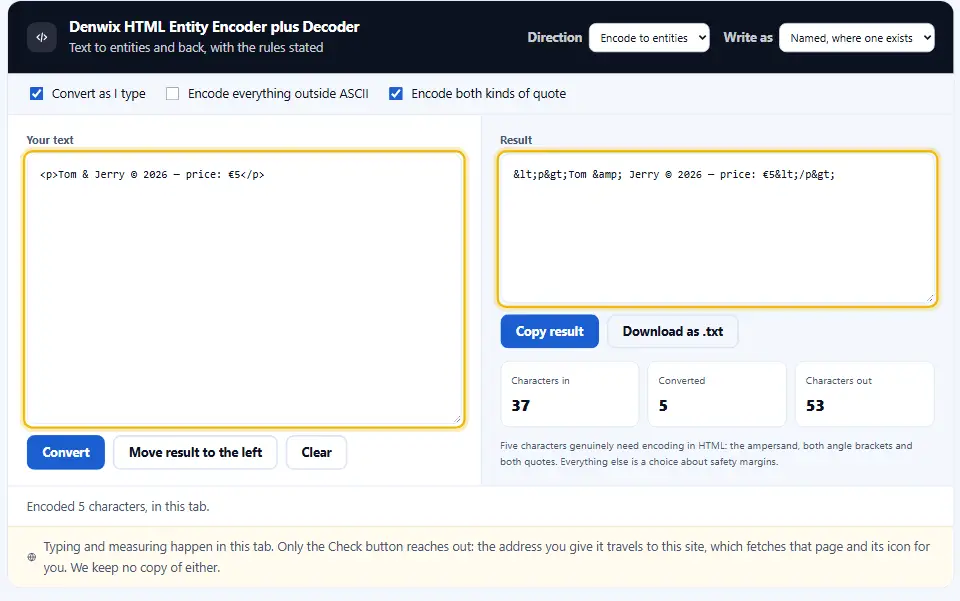
Codificare tutto ciò che è fuori dall’ASCII è un’assicurazione contro un server che invia il charset sbagliato. Tuttavia rende il file più pesante e molto più difficile da modificare.
Perciò ricorrici solo quando non controlli gli header. In ogni altro caso, una dichiarazione del charset corretta è la soluzione migliore.
Le entità non sono sanificazione
Codificare il testo prima di stamparlo in una pagina impedisce che diventi markup. Questo è l’escape e, inoltre, le regole cambiano con il posto: un attributo, un blocco script e un URL richiedono ciascuno il proprio.
Perché decodificare è la metà difficile
I documenti reali contengono entità con nome, decimali, esadecimali e molte senza punto e virgola. Quindi un decodificatore deve gestirle tutte e quattro.

Inoltre deve lasciare stare tutto ciò che sembra solo un’entità. La parola &foo; è testo, e un decodificatore che tira a indovinare rovina la prosa.
Questo decodificatore controlla i nomi nella sua tabella e i code point nell’intervallo valido. Per questo tutto ciò che non riconosce torna esattamente com’era scritto.
Dove compaiono ancora le entità
I vecchi template email ne contengono a centinaia. Così anche gli export dei CMS e le conversioni da PDF e, inoltre, tutto ciò che è passato da un programma di videoscrittura.

Compaiono anche nei file CSV estratti da una pagina web. Per esempio, una colonna di nomi piena di amp e rsquo è il segnale tipico.
Decodificare una volta un file del genere lo rende di nuovo leggibile. Poi vedi le virgolette e le lineette sparse che si nascondevano come codici.
Tuttavia conserva una copia dell’originale. Se un valore doveva restare codificato, vorrai rimetterlo.
Il problema dello spazio unificatore
I programmi di videoscrittura li inseriscono, e sullo schermo sembrano identici a uno spazio normale. Poi rompono l’a capo e i confronti tra testi. Per questo decodificare un blocco incollato è il modo più rapido per trovarli.
In questa pagina
- Lo strumento
- Quali caratteri riserva HTML
- Come usare il codificatore di entità HTML
- Cosa distingue questo codificatore di entità HTML
- Regole per codificare i caratteri speciali HTML
- Sei errori con le entità che arrivano in produzione
- Domande frequenti sulle entità
- Strumenti per lavorare con il markup
Continua
Come usare il codificatore di entità HTML
Tre passaggi, e il risultato segue ogni tasto premuto. Inoltre il pulsante di scambio gestisce l’andata e ritorno.
- 1
Scegli una direzione
Codificare trasforma i caratteri in entità. Invece decodificare riporta le entità a caratteri, comprese quelle senza punto e virgola.
- 2
Scegli la forma
Con nome dove esiste, oppure numeri in decimale o esadecimale. I numeri funzionano sempre, per questo sono l’impostazione predefinita più sicura per le macchine.
- 3
Decidi fin dove arrivare
Lascia spento l’interruttore ASCII per il lavoro normale. Accendilo quando un server invia il charset sbagliato e non puoi correggere gli header.
- 4
Copia, oppure scambia e verifica
Premi Sposta il risultato a sinistra e la direzione si inverte. Poi convertire di nuovo dovrebbe restituire esattamente ciò da cui eri partito.
Cosa distingue questo codificatore di entità HTML
La maggior parte dei convertitori fa bene una direzione e tira a indovinare nell’altra. Ecco invece le differenze che contano nella pratica.
Lascia stare i nomi sconosciuti
Il testo che sembra un’entità ma non lo è resta com’è scritto, perché un decodificatore che indovina rovina la prosa in silenzio.
Tre forme di output
Con nome, decimale ed esadecimale escono da un solo interruttore, così puoi seguire ciò che usa già il file intorno.
Gestisce i punti e virgola mancanti
I documenti reali li omettono, e i browser perdonano un nome noto. Per questo, questo decodificatore fa lo stesso invece di fallire.
Un’andata e ritorno reversibile
Scambia i pannelli e converti di nuovo. Se qualcosa non torna al testo di partenza, hai trovato un bug in uno dei passaggi.
Nessun trucco con il DOM
Questo sito blocca di proposito il solito trucco con innerHTML, quindi le tabelle stanno nel file e ogni scambio avviene alla luce del sole.
Nulla lascia la scheda
Frammenti di template e dati dei clienti passano per convertitori come questo. Per questo qui tutto resta nel tuo browser.
Regole per codificare i caratteri speciali HTML
L’escape è uno di quei lavori in cui l’abitudine giusta è più breve di quella sbagliata.
- Fai l’escape in output, non in input. Salva ciò che l’utente ha scritto. Poi codifica quando lo stampi, e codifica per il punto esatto in cui finisce.
- Usa la funzione del tuo framework. Ogni linguaggio ne ha una, e sa dove finirà il testo. Una catena di sostituzioni fatta a mano prima o poi salta un caso.
- Servi UTF-8 e dichiaralo. Allora accenti ed emoji non hanno bisogno di entità. Soprattutto, è la soluzione che fa sparire l’intera questione.
- Codifica entrambe le virgolette negli attributi. Un apice singolo chiude un attributo tra apici singoli, proprio come uno doppio chiude un attributo tra doppi. Quindi codificali entrambi e non pensarci più.
- Preferisci entità numeriche nei file generati. Non entra in gioco alcuna tabella di nomi, quindi nulla dipende dal fatto che un parser conosca una parola. I nomi aiutano le persone che leggono il sorgente.
- Attento alla doppia codifica. Una e commerciale codificata due volte appare come
&sulla pagina. Perciò decodifica una volta e guarda prima di codificare di nuovo. - Cerca gli spazi unificatori nel testo incollato. Arrivano dai programmi di videoscrittura e rompono l’a capo. Decodifica un blocco, e quelli sparsi diventano visibili.
- Controlla gli export dopo un cambio di CMS. Una migrazione è il momento in cui si infila la doppia codifica. Quindi decodifica un campione delle nuove pagine e confrontalo con le vecchie.
- Mantieni la stessa forma in tutto il file. Mescolare nomi e numeri in un template rende molto più difficile, in seguito, cercare un carattere fuori posto.
- Non fare mai l’escape per sanificare il markup. L’escape rende il testo sicuro da stampare. Consentire alcuni tag e rimuoverne altri è un lavoro diverso, che richiede un vero sanificatore.
Sei errori con le entità che arrivano in produzione
Superano la revisione perché la pagina si vede bene. Tuttavia il danno emerge in un feed, in un export o in un indice di ricerca.
Doppia codifica
Il più comune. Quando il template fa l’escape di un valore e il framework lo rifà, il lettore vede il testo grezzo dell’entità.
Codificare tutto per impostazione predefinita
Raddoppia il peso di una pagina in francese o in urdu e rende il sorgente illeggibile. Quindi sistema il charset.
Fare l’escape per il contesto sbagliato
L’escape HTML in un blocco script o in un parametro URL non basta. Infatti ogni contesto ha le sue regole.
Entità con nome in XML
XML conosce cinque nomi e non di più. Di conseguenza un
in una sitemap o in un feed RSS è un errore di parsing.Dimenticare le virgolette negli attributi
Chiude l’attributo troppo presto e poi lascia il resto del valore come markup. È così che inizia un’iniezione.
Considerare l’escape un controllo di sicurezza
Un escape corretto impedisce l’iniezione nel punto di output. Tuttavia non fa nulla per ciò che hai salvato o permesso.
Domande frequenti sulle entità
Quali caratteri devo codificare in HTML?
Tre nel testo: la e commerciale e le due parentesi angolari. Inoltre, dentro il valore di un attributo codifica anche le virgolette, e codificarle entrambe è più facile da ricordare.
Meglio nomi o numeri?
I nomi si leggono meglio nel sorgente. Invece i numeri funzionano sempre, non richiedono tabelle e sono la scelta più sicura in un file generato da una macchina.
Funziona come decodificatore di entità HTML online?
Sì, e gestisce entità con nome, decimali ed esadecimali, comprese quelle che arrivano senza punto e virgola. Inoltre i nomi sconosciuti restano esattamente come sono scritti.
Perché vedo & sulla mia pagina?
Qualcosa ha codificato il testo due volte. Quindi decodificalo una volta qui per vedere l’originale, poi cerca il secondo escape nel template o nel framework.
Servono entità per le lettere accentate?
Non in un documento UTF-8 con una riga charset corretta. Di conseguenza codificale solo quando non puoi controllare come un server invia il file.
Posso usare queste entità in XML o RSS?
Usa quelle numeriche. Infatti XML definisce solo cinque entità con nome, quindi qualsiasi altra, nbsp compresa, rompe il feed.
E i caratteri speciali HTML nelle email?
I client di posta leggono l’HTML con motori più vecchi, quindi lì le entità numeriche sono la scelta più sicura. Inoltre prova in un client reale prima dell’invio.
Codificare è come sanificare?
No. Codificare fa apparire il testo come testo. Invece sanificare decide quali tag possono restare markup, e quel lavoro richiede una libreria fatta apposta.
Posso decodificare un intero file qui?
Incollalo. Lo strumento gestisce una pagina lunga senza rallentare e, inoltre, i conteggi ti dicono quanti codici ha sostituito.
Quali entità rompono un feed RSS?
Qualsiasi entità con nome tranne le cinque definite da XML. Di solito la colpevole è nbsp, e sostituirla con un codice numerico ripara il feed.
Perché il mio testo mostra virgolette strane?
Un programma di videoscrittura ha inserito virgolette tipografiche e qualcosa le ha codificate due volte. Per questo basta decodificare il blocco una volta qui per ritrovare i caratteri veri.
Devo codificare l’apostrofo?
Dentro un attributo tra apici singoli sì, e l’interruttore delle virgolette lo fa per te. Invece nel testo un apostrofo è normale punteggiatura, quindi può restare com’è.
Perché la mia e commerciale è rimasta intatta?
Perché il codificatore era in modalità decodifica, oppure il carattere faceva già parte di un’entità. Quindi cambia direzione e converti di nuovo per vedere la differenza.
Ciò che incollo qui viene caricato?
No. Entrambe le direzioni girano nella scheda del browser. Di conseguenza nulla arriva a questo sito, non viene conservata alcuna copia e chiudere la scheda cancella tutto.
Strumenti per lavorare con il markup
Le entità sono una parte del lavoro manuale sull’HTML. Questi tre coprono il resto.
Minificatore HTML
Comprimi il markup o riformattalo in modo leggibile.
Apri lo strumento →Rimozione tag HTML
Estrai il testo semplice e conserva gli a capo dei paragrafi.
Apri lo strumento →Codificatore e decodificatore Base64
Codifica byte per una data URI o il valore di un header.
Apri lo strumento →
Pronto a convertire qualcosa?
Incolla un blocco, scegli una direzione e scambia i pannelli per verificare l’andata e ritorno. Il codificatore di entità HTML è gratis, non chiede account e gira interamente nel browser.