Controllo codici di stato HTTP
Cosa viene detto davvero a un crawler
Questo controllo codici di stato HTTP chiede a un indirizzo le sue intestazioni e ti mostra cosa viene detto a un crawler. Ottieni il codice, una spiegazione chiara, il server che c’è dietro e le intestazioni che decidono se i motori indicizzano la pagina.
- GratisPrezzo
- 15Codici spiegati
- MaiPagina scaricata
- NessunaRegistrazione
Controllo codici di stato HTTP
Cosa riceve davvero un crawler da un indirizzo
Solo indirizzi pubblici sulle porte 80 e 443. Leggiamo gli header di risposta e ci fermiamo lì, quindi la pagina stessa non viene mai scaricata.
Pronto. Incolla un indirizzo e premi il pulsante.
Perché usare un controllo codici di stato HTTP
Ogni richiesta riceve una risposta di tre cifre prima di qualsiasi altra cosa. Quel numero decide se un crawler legge la pagina o se ne va.
Il tuo browser lo nasconde. Mostra la pagina o un errore, quindi il codice vero resta fuori vista a meno che tu non lo cerchi.
Questo divario crea problemi veri. Poiché una bella pagina di errore può rispondere 200, un’intera sezione può sembrarti rotta e invece perfettamente sana per Google.
Ogni numero porta un significato concordato. La RFC 9110, che definisce i codici di stato è il luogo dove quei significati sono scritti.
Cosa significa ogni famiglia di codici
I codici che iniziano con 2 significano successo, e 200 è quello che vuoi su una pagina attiva. Quindi lì non c’è altro a cui pensare.

I codici che iniziano con 3 significano un reindirizzamento, quindi il server punta altrove. Nel frattempo il 4 significa che il problema era la richiesta, e il 404 guida quel gruppo.

I codici che iniziano con 5 significano che il server si è rotto. Poiché di solito è il tuo stesso codice a fallire, il log degli errori è il primo posto dove guardare.
Le intestazioni che decidono l’indicizzazione
Una pagina può caricarsi perfettamente e comunque chiedere di restare fuori dalla ricerca. L’intestazione X-Robots-Tag lo fa in silenzio, sopra l’HTML.

Tuttavia nessuno la vede in un browser. Perciò una pagina sparita dai risultati senza motivo visibile merita prima un controllo qui.
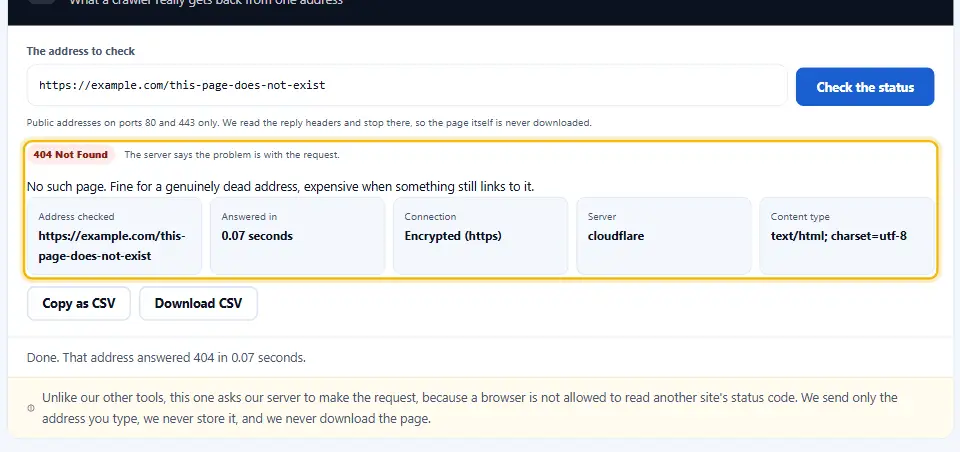
Il report mostra quell’intestazione quando esiste. Inoltre mostra la destinazione del reindirizzamento, il tipo di contenuto e qualsiasi impostazione HSTS.
La trappola del soft 404
Un soft 404 è una pagina mancante che risponde 200 e mostra un messaggio gentile. I motori tengono l’indirizzo nell’indice, lo scansionano ancora e ancora e infine decidono che l’intero sito gestisce male gli errori. Un vero 404 o 410 lo risolve con una sola riga di configurazione.
Come usare il controllo codici di stato HTTP
Due passaggi fino alla risposta, e altri due che vale la pena fare. Poiché tornano solo le intestazioni, tutto finisce in circa un secondo.
- 1
Incolla l’indirizzo
Qualsiasi pagina pubblica su http o https. L’indirizzo completo funziona meglio, protocollo incluso.
- 2
Premi il pulsante
Chiediamo all’indirizzo le intestazioni e leggiamo la risposta. Il corpo della pagina non viene mai richiesto.
- 3
Leggi la spiegazione
Quindici codici comuni arrivano con una frase su cosa significano nella pratica, anziché nella specifica.
- 4
Approfondisci se reindirizza
Una risposta 3xx significa che dietro c’è una catena. Poi il controllo dei reindirizzamenti mostra ogni salto.
Cosa segnala questo controllo di stato
Un numero da solo non ti dice quasi nulla. Invece questo controllo spiega il codice e mostra le intestazioni attorno.
Parole semplici per ogni codice
Un 410 e un 404 differiscono in modi che contano. Per questo ogni codice comune arriva con una frase sul suo effetto reale.
Le intestazioni che usa un crawler
Compaiono X-Robots-Tag, Cache-Control, Last-Modified e la destinazione del reindirizzamento. Perciò vedi il quadro dell’indicizzazione, non solo il codice.
Viaggiano solo le intestazioni
Inviamo una richiesta di sole intestazioni e ci fermiamo lì. Di conseguenza la pagina stessa non viene mai scaricata né letta.
Cifratura segnalata
Il report dice se la connessione è rimasta cifrata e se HSTS è attivo. Inoltre entrambe le cose contano più di quanto si pensi.
Indirizzi privati rifiutati
Nomi interni e reti private vengono respinti prima che si apra qualsiasi connessione. Poiché tutto gira sul nostro server, quel limite non è facoltativo.
Nulla conservato dopo
L’indirizzo che scrivi serve per una richiesta e poi sparisce. Non salviamo alcuna cronologia, e non esiste un account a cui collegarla.
Abitudini sui codici di stato
I codici costano poco da controllare e molto da ignorare. Per questo queste sei abitudini intercettano quasi tutto ciò che va storto.
- Controlla dopo ogni lancio. Prova la home e due pagine profonde appena finisce un deploy. Così un percorso rotto emerge in minuti invece che in settimane.
- Servi 404 veri. Una pagina mancante deve rispondere 404, per quanto gentile sia il design. Altrimenti i motori tengono in vita l’indirizzo morto.
- Usa 410 quando lo intendi davvero. Una pagina eliminata di proposito merita un 410. Poiché quel codice è definitivo, i motori la rimuovono prima di un 404.
- Tieni d’occhio i 403 vaganti. Una regola del firewall può bloccare i crawler e lasciare passare te. Di conseguenza una pagina che per te funziona può essere invisibile per Google.
- Restituisci 503 durante la manutenzione. Dice ai crawler di tornare più tardi invece di registrare un errore. Inoltre un’intestazione Retry-After rende il messaggio ancora più chiaro.
- Controlla l’indirizzo, non la pagina. Prova l’indirizzo esatto che compare nella sitemap. Poiché una barra finale può cambiare la risposta, qui i dettagli contano.
Trappole dei codici di stato da conoscere
Ognuna sembra a posto nella finestra del browser. Tuttavia ognuna cambia ciò che i motori fanno con la tua pagina.
Il finto 404 gentile
Una pagina di errore che restituisce 200 tiene indicizzati indirizzi morti. Così il sito sembra più grande e più povero di quanto sia.
Un 302 che non finisce mai
I reindirizzamenti temporanei lasciati attivi per anni confondono tutti. Invece di aspettare, passali a 301 appena lo spostamento è definitivo.
Bloccare solo il crawler
Alcuni firewall rispondono 403 ai bot e 200 alle persone. Tuttavia te ne accorgi solo quando il traffico è già sparito.
I tuoi dubbi sui codici di stato
Perché questo strumento usa il vostro server?
Un browser non può leggere le intestazioni di risposta di un altro sito, perché la same-origin policy lo blocca. Quindi la richiesta parte dal nostro server. Inviamo solo l’indirizzo che hai scritto e poi non conserviamo nulla.
Il controllo scarica la mia pagina?
No. Chiediamo solo le intestazioni e chiudiamo la connessione appena arrivano. Così la tua banda quasi non se ne accorge, e nessun contenuto ci arriva mai.
Cosa significa un 403 per la SEO?
Vuol dire che il server non ha accettato la domanda. I crawler lo trattano come una porta chiusa, quindi nulla di lì arriva nell’indice finché dura. Infatti firewall e regole anti-bot ne causano la maggior parte.
Un 301 è meglio di un 302?
Per uno spostamento permanente sì. Un 301 dice ai motori di trasferire i segnali della vecchia pagina, mentre un 302 chiede di conservare il vecchio indirizzo. In breve, adatta il codice alla tua intenzione.
Posso controllare una pagina dietro un login?
Otterrai un 401 o un 403, che è la risposta onesta. Inoltre è esattamente ciò che vede un crawler, quindi il risultato ti dice qualcosa di utile anche se la pagina resta nascosta.
Quante verifiche posso fare?
Un numero moderato per visitatore, così lo strumento resta disponibile per tutti. L’uso normale non lo raggiunge mai, e in ogni caso non chiediamo registrazione.
Approfondisci con questi
Un codice di stato spesso solleva la domanda successiva. Per questo questi tre rispondono.
Controllo catene di reindirizzamento
Vedi ogni salto tra un indirizzo e la pagina finale.
Apri lo strumento →Controllo SSL
Leggi il certificato attivo e i giorni che gli restano.
Apri lo strumento →Validatore robots.txt
Scopri se un crawler è autorizzato a entrare lì.
Apri lo strumento →
Controlla cosa risponde il tuo server
Incolla un indirizzo, premi il pulsante e leggi la risposta reale. È gratis, richiede un secondo e non scarica mai nessuna pagina.