ماذا تعني محظورة بواسطة robots.txt
تقول Search Console إن بعض الصفحات محظورة بواسطة robots.txt. وهذا يعني أن ملف robots.txt يطلب من Google عدم الزحف إليها. لذلك لا تستطيع Google قراءتها، ونادرًا ما تظهر في البحث.
أحيانًا يكون هذا ما تريده بالضبط، مثل سلة الشراء أو لوحة الإدارة. لكن إذا ذكر التقرير صفحتك الرئيسية أو متجرك أو مقالاتك، فهناك خطأ في الملف.

الخطوة 1: ابحث عن السطر الذي يحظر
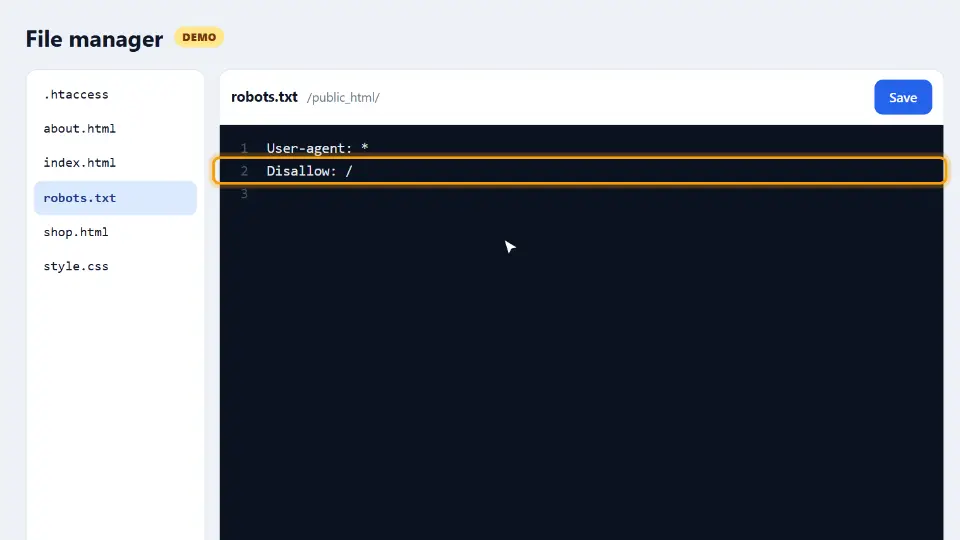
افتح ملف robots.txt لموقعك. فهو يوجد دائمًا في الجذر، مثل https://example.com/robots.txt. وفي العرض كان يحتوي سطرين فقط:
User-agent: *
Disallow: /
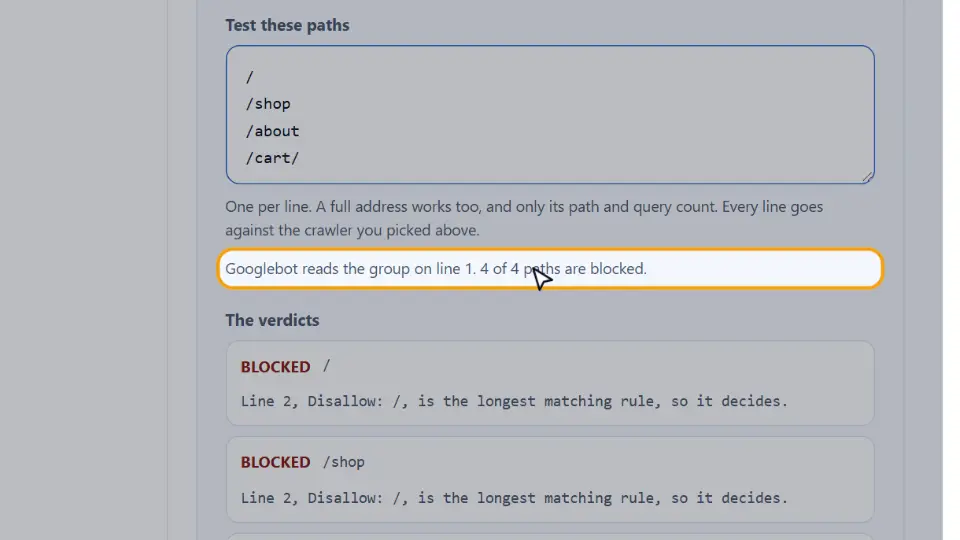
هذان السطران يحظران الموقع كله على كل زاحف. بعد ذلك الصق الملف في مدقق robots.txt المجاني وجرّب بعض العناوين. فهو يعرض القاعدة التي تحظر كل صفحة، لذلك ترى السبب فورًا.
من أين يأتي هذا السطر. غالبًا ما يكون بقية من موقع اختبار، حيث كان حظر كل شيء منطقيًا. وعندما انتقل الموقع إلى النشر، انتقل الملف معه.
الخطوة 2: أصلح الملف
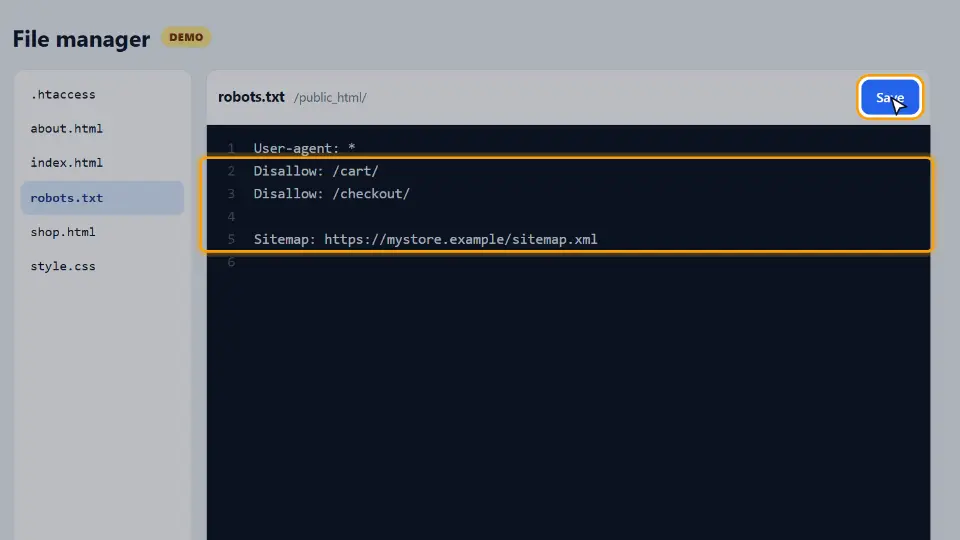
استبدل السطر الحاظر. احظر فقط ما يجب أن يبقى خارج البحث، مثل السلة والدفع، وأضف عنوان خريطة الموقع:
User-agent: *
Disallow: /cart/
Disallow: /checkout/

Sitemap: https://example.com/sitemap.xml
احفظ الملف في لوحة الاستضافة أو ارفعه عبر FTP. ثم افتح الملف المنشور في المتصفح لتتأكد من القواعد الجديدة.
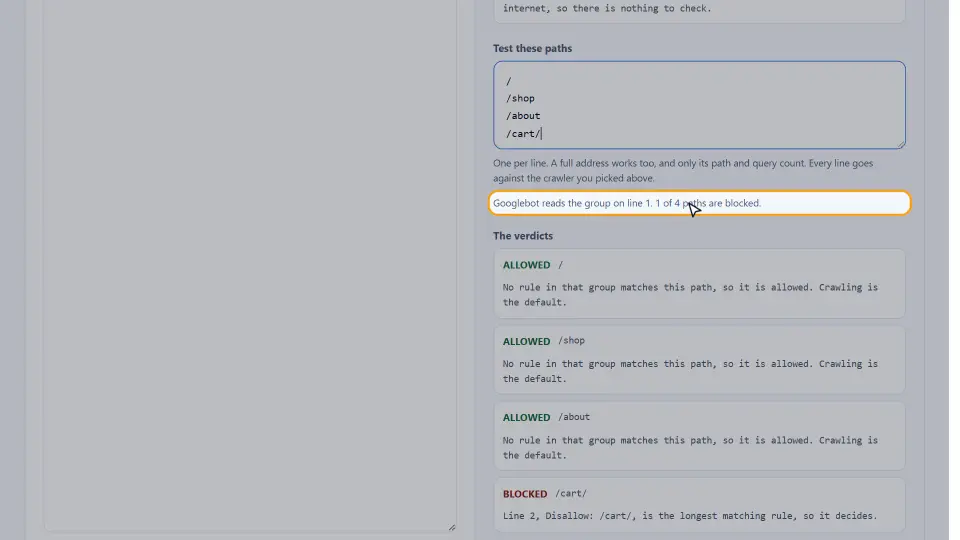
شغّل المدقق مرة أخرى. ففي العرض أصبحت الصفحة الرئيسية والمتجر وصفحة من نحن مسموحة، وبقيت السلة محظورة كما خُطط.
أمثلة على robots.txt
استخدمها نقطة بداية، ثم اختبرها بالمدقق. كما يمكن لـ مولّد robots.txt إنشاء الملف لك.
السماح بكل شيء
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
موقع ووردبريس نموذجي
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap_index.xml
حظر مجلد على زاحف واحد
User-agent: Googlebot-Image
Disallow: /private-photos/
كيف تقرأ Google القواعد
تتبع Google مجموعة وكيلها الخاص، أو مجموعة * إن لم توجد. وداخل المجموعة تفوز القاعدة الأكثر تحديدًا. لذلك تتغلب Allow: /wp-admin/admin-ajax.php على Disallow: /wp-admin/ لهذا الملف.
robots.txt ليس noindex
أمر يُخلط فيه كثيرًا: robots.txt يوقف الزحف لا الفهرسة. فإذا ربطت مواقع أخرى بصفحة محظورة، قد تعرض Google عنوانها لكن بلا وصف.
لإبقاء صفحة خارج Google استخدم بدلًا من ذلك وسم meta noindex. ودع Google تزحف إلى الصفحة حتى ترى الوسم. بعبارة أخرى، لا تحظر صفحة في robots.txt وتضع لها noindex في الوقت نفسه.
الخطوة 3: اطلب من Google إعادة الزحف
وأخيرًا افتح Google Search Console. وفي تقرير فهرسة الصفحات افتح مجموعة «محظورة بواسطة robots.txt» وانقر على التحقق من الإصلاح. ثم تزحف Google إلى تلك الصفحات من جديد.
قد يستغرق التحقق من أيام إلى أسابيع. وفي الأثناء يمكنك استخدام أداة فحص عنوان URL على أهم صفحة وطلب فهرستها.
ووردبريس ومواقع الاختبار
في ووردبريس خيار «منع محركات البحث من أرشفة هذا الموقع» في الإعدادات، القراءة. وهو مفيد على موقع الاختبار. لكن إذا بقي مفعّلًا بعد الإطلاق، فإن موقعك المنشور يطلب من المحركات الابتعاد.
لذلك افحص بعد كل إطلاق أو نقل هذا الخيار وملف robots.txt ووسوم meta robots. فقائمة فحص قصيرة توفّر أسابيع من الزيارات الضائعة.
robots.txt disallow: كيف تُطابَق القواعد
معظم أخطاء ملف robots.txt تأتي من قاعدة تطابق أكثر مما قصدت. لذلك من المفيد أن تعرف بالضبط كيف تقرأ Google سطر robots.txt disallow. القواعد قليلة وقصيرة، وبمجرد أن تفهمها لن يبقى الملف لعبة تخمين، بل يصبح أداة دقيقة تعرف نتيجتها مسبقًا.
المطابقة الأطول هي التي تفوز. لا تقرأ Google القواعد من الأعلى إلى الأسفل ثم تتوقف عند أول تطابق. بل تنظر في كل قواعد المجموعة، ثم تختار القاعدة ذات المسار المطابق الأطول. مثلًا مع Disallow: /shop/ وAllow: /shop/sale/ تبقى صفحات التخفيضات مفتوحة، لأن مسار Allow أطول. وإذا تساوت قاعدتان في الطول، تفوز قاعدة Allow. لذلك لا يهم ترتيب الأسطر داخل المجموعة، بل يهم طول المسار.
الرموز البديلة: النجمة وعلامة الدولار. يجعل رمزان القواعدَ أكثر مرونة. النجمة * تطابق أي سلسلة من الحروف، لذلك يحجب Disallow: /*?sort= كل القوائم المرتّبة. أما علامة الدولار $ فتعني نهاية العنوان، لذلك يحجب Disallow: /*.pdf$ ملفات PDF فقط، لا صفحة اسمها /pdf-guide/. ومع ذلك استخدمهما بحذر، لأن نجمة واحدة في غير مكانها قد تحجب قسمًا كاملًا من الموقع دون أن تنتبه.
الشرطة المائلة في النهاية تغيّر كل شيء. تُقارَن المسارات من بدايتها، وهي تفرّق بين الحروف الكبيرة والصغيرة. لذلك يحجب Disallow: /cart المسار /cart و/cart/ وحتى /cartoons/. في المقابل يحجب Disallow: /cart/ فقط ما يوجد داخل ذلك المجلد. كذلك فإن /Cart/ و/cart/ مساران مختلفان تمامًا. لهذا إذا كنت مترددًا فأنهِ قواعد المجلدات بشرطة مائلة دائمًا.
سطر Disallow الفارغ لا يحجب شيئًا
السطر Disallow: الذي لا يأتي بعده شيء يسمح بكل الصفحات. في الواقع هذه هي الطريقة المعتادة لتقول إن الزاحف يستطيع زيارة كل صفحة. الخطر في الحالة المعاكسة: شرطة مائلة واحدة، أي Disallow: /، تحجب الموقع كله دفعة واحدة.
كيف تختبر ملف robots.txt قبل رفعه
يسري أي تغيير في ملف robots.txt لحظة حفظه، وقد تقرؤه Google خلال ساعات قليلة. لذلك اختبر كل تغيير قبل رفعه. يستغرق الأمر دقيقة واحدة، لكنه يحميك من أسابيع من الزيارات الضائعة ومن صفحات تختفي من نتائج البحث.
اختبر المسارات التي تهمك. الصق ملفك في مدقق robots.txt المجاني لدينا، ثم اكتب العناوين المهمة: الصفحة الرئيسية، وصفحة منتج، ومقالة من المدونة، وأي مجلد تريد حجبه. لكل عنوان تُظهر الأداة Allowed أو Blocked، وتذكر السطر الدقيق الذي يحسم الأمر. فإذا ظهرت صفحة تحتاجها محجوبة، ترى القاعدة المسؤولة فورًا وتعرف ما الذي يجب تعديله.
افحص كل مجموعة زواحف. يمكن أن يحوي الملف مجموعات منفصلة لزواحف مختلفة، مثل User-agent: Googlebot وUser-agent: *. يتبع الزاحف فقط المجموعة الأدق التي تذكره بالاسم، ويتجاهل الباقي. لذلك إذا أضفت مجموعة خاصة بـ Googlebot، فانسخ إليها كل قاعدة ما زال يحتاجها، لأنه لن يقرأ مجموعة النجمة بعد ذلك. هذا خطأ شائع يفتح صفحات كنت تظنها محجوبة.
أين يجب أن يوجد الملف. لا يعمل الملف إلا في جذر المضيف، مثل https://example.com/robots.txt. أما نسخة داخل مجلد فرعي فلا تفعل شيئًا. كما يحتاج كل نطاق فرعي إلى ملفه الخاص، وكذلك كل بروتوكول. وتقرأ Google حتى 500 كيلوبايت من الملف وتتجاهل ما بعدها، لذلك اجعله قصيرًا وواضحًا.
ماذا يحدث إذا فشل تحميل الملف. إذا أعاد ملف robots.txt الخطأ 404، تعامل Google الموقع كأنه بلا قواعد، فتزحف إلى كل شيء. لكن إذا أعاد الخادم خطأ من نوع 5xx، توقف Google الزحف مؤقتًا، لأنها لا تستطيع معرفة المسموح. وبهذا قد يبدو الخادم المعطّل كأنه حجب من robots.txt. لذلك افحص رمز الحالة أيضًا باستخدام HTTP Header Checker.
أخطاء شائعة
- إبقاء
Disallow: /من موقع الاختبار بعد الإطلاق. - حظر مجلدات CSS وJavaScript، فلا تستطيع Google عرض الصفحة.
- استخدام robots.txt لإخفاء صفحة كان يجب أن تحمل noindex.
- نسيان الشرطة المائلة في النهاية، فيحظر
Disallow: /blogأيضًا /blog-tips/. - وضع robots.txt في مجلد فرعي؛ فهو لا يعمل إلا في الجذر.
باختصار: ابحث عن السطر الحاظر، واحظر الخاص فقط، واطلب إعادة الزحف. ولشرح كل قاعدة بالتفصيل راجع دليل Google عن robots.txt.
أسئلة وأجوبة
ماذا تعني محظورة بواسطة robots.txt؟
ملف robots.txt يطلب من Google عدم الزحف إلى هذه الصفحات، لذلك لا تستطيع قراءتها ونادرًا ما تعرضها.
كيف أصلح الصفحات المحظورة بواسطة robots.txt؟
ابحث عن سطر Disallow المطابق لها، واحذفه أو ضيّقه، واحفظ الملف، ثم انقر على التحقق من الإصلاح في Search Console.
أين يوجد ملف robots.txt؟
في جذر نطاقك، مثل https://example.com/robots.txt. والمجلدات الفرعية لا تُحتسب.
كيف أختبر robots.txt؟
الصقه في مدقق robots.txt المجاني وجرّب العناوين المهمة. وبذلك ترى القاعدة التي تسمح بكل عنوان أو تحظره.
هل يحذف robots.txt صفحة من Google؟
لا، لأنه يوقف الزحف لا الفهرسة. استخدم وسم noindex ودع Google تزحف إلى الصفحة.
لماذا تفهرس Google صفحة محظورة بواسطة robots.txt؟
لأن مواقع أخرى تربط بها فتعرف Google العنوان. وتعرضه بلا وصف لأنها لا تستطيع قراءة الصفحة.
ماذا يفعل Disallow: /؟
يحظر الموقع كله على زواحف تلك المجموعة. وعلى موقع منشور يكون غالبًا خطأ.
ما robots.txt المناسب لووردبريس؟
احظر /wp-admin/، واسمح بـ /wp-admin/admin-ajax.php، وأضف سطر خريطة الموقع. كما لا تحظر CSS أو JavaScript.
هل أحظر CSS وJavaScript؟
لا، لأن Google تحتاجهما لعرض الصفحة وتقييم تصميمها ونسخة الجوال.
كم تستغرق Google لإعادة الزحف؟
غالبًا بضعة أيام. وقد يستغرق التحقق في Search Console أسابيع مع صفحات كثيرة.
ما توجيه Allow؟
يسمح لزاحف بالوصول إلى مسار داخل مجلد محظور. وتفوز القاعدة الأكثر تحديدًا.
هل يمكنني حظر زواحف الذكاء الاصطناعي في robots.txt؟
نعم، بذكر وكيلها مثل GPTBot مع Disallow: /. والزواحف الملتزمة تحترم ذلك.
هل يحمي robots.txt الملفات الخاصة؟
لا، لأنه عام ومجرد طلب. لذلك احمِ الملفات الخاصة بكلمة مرور.
ما سطر Sitemap في robots.txt؟
سطر مثل Sitemap: https://example.com/sitemap.xml يخبر الزواحف بمكان خريطة موقعك.
هل يؤثر خيار ووردبريس لمنع المحركات على robots.txt؟
نعم، لأنه يضيف إشارة noindex وقد يغيّر robots.txt الافتراضي. لذلك أوقفه بعد الإطلاق.
هل يميّز robots.txt بين الأحرف الكبيرة والصغيرة؟
في المسارات نعم. فـ Disallow: /Blog/ لا يحظر /blog/، لذلك طابق كتابة عناوينك.
ماذا يحدث من دون robots.txt؟
تعامل الزواحف الموقع كله على أنه مسموح. وهذا مناسب لمعظم المواقع الصغيرة.
هل يضر robots.txt السيئ بترتيبي؟
نعم. فإذا حظر صفحات مهمة، لا تستطيع Google قراءتها، فتخرج من البحث مع الوقت.
كيف أنشئ ملف robots.txt؟
استخدم مولّد robots.txt المجاني، ثم ارفع الملف إلى جذر موقعك.
هل يقرأ مدقق السيو ملف robots.txt؟
نعم. يعرض مدقق السيو لدينا ملف robots.txt، وينبّه عندما يحظر الصفحة التي تختبرها.
هل يُخفي ملف robots.txt الصفحة عن الناس؟
لا. يستطيع أي شخص فتح الصفحة بعنوانها، ويستطيع أي شخص قراءة ملف robots.txt نفسه. لذلك لا تستخدمه أبدًا لإخفاء صفحات خاصة، لأنه في الواقع يدلّ الفضوليين عليها. ضع الصفحات الخاصة خلف تسجيل دخول بدلًا من ذلك.
هل أستطيع حجب زواحف الذكاء الاصطناعي بملف robots.txt؟
نعم، إذا كانت تلتزم بالقواعد. أضف مجموعة لكل زاحف، مثل User-agent: GPTBot مع Disallow: /. لكن الزاحف الذي يتجاهل الملف لن يوقفه شيء فيه، لذلك تحتاج حينها إلى حجب على مستوى الخادم أو جدار الحماية.
هل أحجب ملفات CSS وJavaScript؟
لا. تعرض Google الصفحات كما يعرضها المتصفح، لذلك تحتاج إلى ملفات التنسيق والسكربتات لترى التصميم كاملًا. وإذا حجبتها فقد تبدو الصفحة معطّلة في نظر Google، وهذا قد يضر بترتيبها في نتائج البحث.
كم تحتاج Google لتلاحظ تغيير robots.txt؟
تحفظ Google الملف عادةً لمدة تصل إلى يوم واحد. لذلك قد يحتاج الإصلاح يومًا ليبدأ مفعوله. بعد ذلك يعود الزحف إلى الصفحات المفتوحة بوتيرته الطبيعية، وتستطيع تسريع الأمر بطلب الفهرسة من Search Console.
هل ملف robots.txt إلزامي؟
لا. بدون الملف تزور الزواحف كل صفحة تجدها. ومع ذلك يساعد ملف قصير فيه سطر Sitemap الزواحفَ على إيجاد صفحاتك، كما يمنع ظهور أخطاء 404 في سجلات الخادم كلما طلبت الزواحف الملف.
ما الفرق بين Disallow وnoindex؟
يمنع Disallow الزحف إلى الصفحة، لكنه لا يمنع ظهور عنوانها في النتائج إذا وجدت Google روابط إليها. أما noindex فيمنع الفهرسة، لكنه يعمل فقط إذا استطاعت Google الزحف إلى الصفحة وقراءة الوسم. لذلك لا تجمع بينهما على الصفحة نفسها.
هل يؤثر خطأ في ملف robots.txt على الموقع كله؟
قد يؤثر نعم. سطر واحد مثل Disallow: / يحجب كل الصفحات عن الزواحف، فتبدأ الصفحات في الاختفاء من النتائج تدريجيًا. لذلك اختبر كل تغيير في المدقق قبل الحفظ، وراجع تقرير الصفحات في Search Console بعد أي تعديل.
أين أضع سطر Sitemap في ملف robots.txt؟
يمكنك وضعه في أي مكان من الملف، لأنه لا يتبع أي مجموعة User-agent. لكن من الأوضح أن تضعه في النهاية، مع العنوان الكامل الذي يبدأ بـ https. ويمكنك أيضًا إضافة أكثر من سطر Sitemap إذا كان لموقعك أكثر من خريطة.
هل يحجب robots.txt الصور من الظهور في بحث الصور؟
نعم، إذا حجبت مسار الصور عن Googlebot-Image أو عن كل الزواحف. لكن كن حذرًا، لأن حجب مجلد الصور قد يمنع Google من رؤية صور صفحاتك العادية أيضًا. لذلك احجب فقط الصور التي لا تريد ظهورها، لا المجلد كله. وبعد أي تعديل افتح الملف في المتصفح بعنوانه الكامل، وتأكد أن الخادم يعرض النسخة الجديدة فعلًا لا نسخة قديمة من الذاكرة المؤقتة.