Cosa significa bloccata da robots.txt
Search Console dice che alcune pagine sono bloccate da robots.txt. Vuol dire che il file robots.txt chiede a Google di non scansionarle. Quindi Google non può leggerle e quasi mai compaiono nei risultati.
A volte è proprio ciò che vuoi, per esempio per un carrello o un’area di amministrazione. Ma se il rapporto elenca la home, il negozio o gli articoli, nel file c’è un errore.

Passo 1: trova la riga che blocca
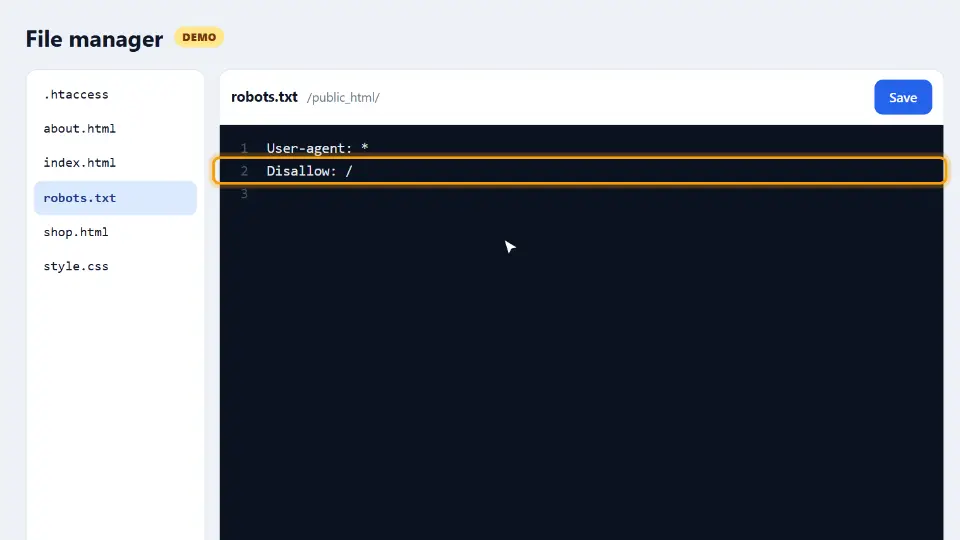
Carica nel browser il robots.txt del tuo sito. Si trova sempre nella radice, per esempio https://example.com/robots.txt. Nella nostra demo conteneva solo due righe:
User-agent: *
Disallow: /
Queste due righe bloccano tutto il sito per ogni crawler. Poi incolla il file nel nostro Robots.txt Validator gratuito e prova alcuni indirizzi. Mostra quale regola blocca ogni pagina, così vedi subito il colpevole.
Da dove arriva questa riga. Quasi sempre è un residuo di un sito di prova, dove bloccare tutto aveva senso. Quando il sito è andato online, il file è quindi rimasto.
Passo 2: correggi il file
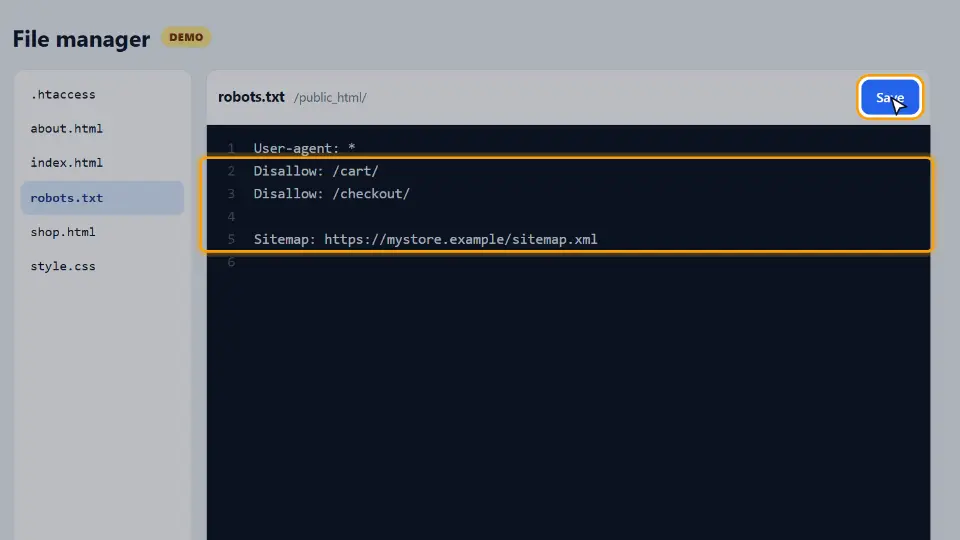
Sostituisci la riga che blocca. Blocca solo ciò che deve restare fuori dalla ricerca, come carrello e cassa, e aggiungi l’indirizzo della sitemap:
User-agent: *
Disallow: /cart/
Disallow: /checkout/

Sitemap: https://example.com/sitemap.xml
Salva il file nel pannello dell’hosting o caricalo via FTP. Poi apri il file online nel browser per verificare le nuove regole.
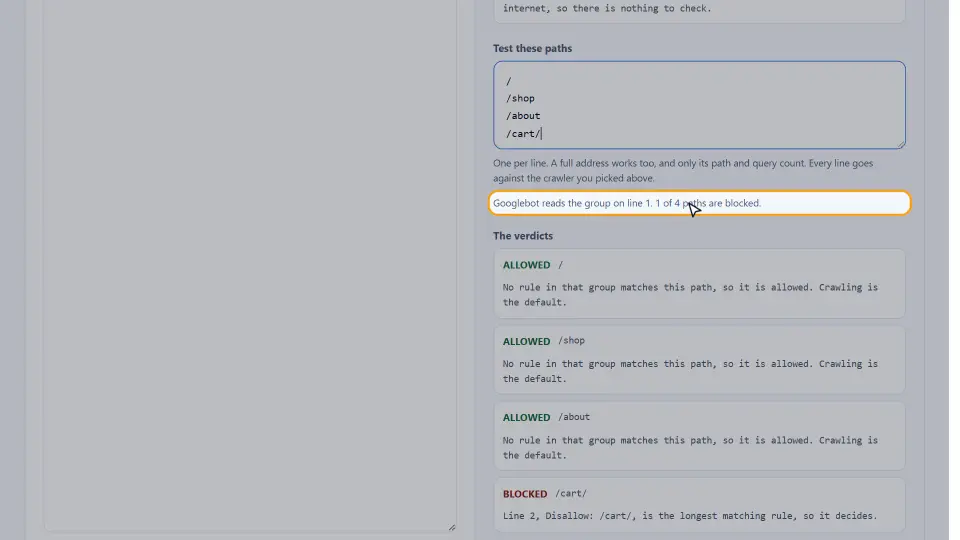
Rilancia il validatore. Nella nostra demo home, negozio e pagina chi siamo erano consentiti, e il carrello restava bloccato, come previsto.
Esempi di robots.txt
Usali come punto di partenza, poi provali con il validatore. Inoltre il nostro Robots.txt Generator può creare il file per te.
Consentire tutto
User-agent: *
Disallow:

Sitemap: https://example.com/sitemap.xml
Un tipico sito WordPress
User-agent: *
Disallow: /wp-admin/
Allow: /wp-admin/admin-ajax.php

Sitemap: https://example.com/sitemap_index.xml
Bloccare una cartella per un crawler
User-agent: Googlebot-Image
Disallow: /private-photos/
Come Google legge le regole
Google segue il gruppo del proprio user agent, oppure il gruppo * se non c’è. In ogni gruppo decide la regola più precisa. Ecco perché la riga Allow vale per admin-ajax.php, anche se /wp-admin/ è chiusa.
robots.txt non è noindex
Una cosa che si confonde spesso: robots.txt ferma la scansione, non l’indicizzazione. Se altri siti collegano una pagina bloccata, Google può comunque mostrarne l’indirizzo, però senza descrizione.
Per tenere una pagina fuori da Google usa invece un meta tag noindex. E lascia che Google scansioni la pagina, così vede il tag. In altre parole, non bloccare mai una pagina in robots.txt mettendo anche noindex.
Passo 3: chiedi a Google una nuova scansione
Infine apri Google Search Console. Nel rapporto sull’indicizzazione delle pagine apri il gruppo «Bloccata da robots.txt» e fai clic su Convalida correzione. Google poi scansiona di nuovo quelle pagine.
La convalida può richiedere da qualche giorno a qualche settimana. Nel frattempo puoi usare il Controllo URL sulla pagina più importante e chiederne l’indicizzazione.
WordPress e siti di prova
In WordPress, sotto Impostazioni, Lettura, c’è una casella che chiede ai motori di restare fuori. Su un sito di prova è utile. Tuttavia, se resta attiva dopo il lancio, il sito online chiede ai motori di restare fuori.
Per questo, dopo ogni lancio o migrazione, controlla quella casella, il file robots.txt e i meta tag robots. Una breve lista di controllo evita settimane di traffico perso.
robots.txt disallow: come funzionano le regole
La maggior parte degli errori nel robots.txt nasce da una regola che copre più del previsto. Per questo conviene sapere come Google legge una riga robots.txt disallow. Le regole sono poche e, una volta capite, il file smette di essere un indovinello.
Vince la corrispondenza più lunga. Google non legge le regole dall’alto in basso e non si ferma alla prima. Invece guarda tutte le regole del gruppo e sceglie quella con il percorso corrispondente più lungo. Per esempio, con Disallow: /shop/ e Allow: /shop/sale/ le pagine dei saldi restano aperte, perché il percorso Allow è più lungo. Se due regole sono lunghe uguali, vince Allow.
I caratteri jolly: asterisco e dollaro. Due simboli rendono le regole più flessibili. L’asterisco * vale per qualsiasi sequenza di caratteri, quindi Disallow: /*?sort= blocca tutte le liste ordinate. Il dollaro $ segna la fine dell’indirizzo, così Disallow: /*.pdf$ blocca i PDF ma non una pagina chiamata /pdf-guide/. Tuttavia usali con cautela, perché un asterisco sbagliato blocca un’intera sezione.
Una barra finale cambia tutto. I percorsi si confrontano dall’inizio e distinguono maiuscole e minuscole. Di conseguenza Disallow: /cart blocca /cart, /cart/ e perfino /cartoons/. Invece Disallow: /cart/ blocca solo ciò che sta dentro quella cartella. Allo stesso modo /Cart/ e /cart/ sono due percorsi diversi. Nel dubbio, chiudi le regole delle cartelle con una barra.
Un Disallow vuoto non blocca nulla
Una riga Disallow: senza niente dopo consente tutto. Infatti è il modo standard per dire che un crawler può visitare ogni pagina. Il pericolo è il caso opposto: una sola barra, Disallow: /, blocca l’intero sito.
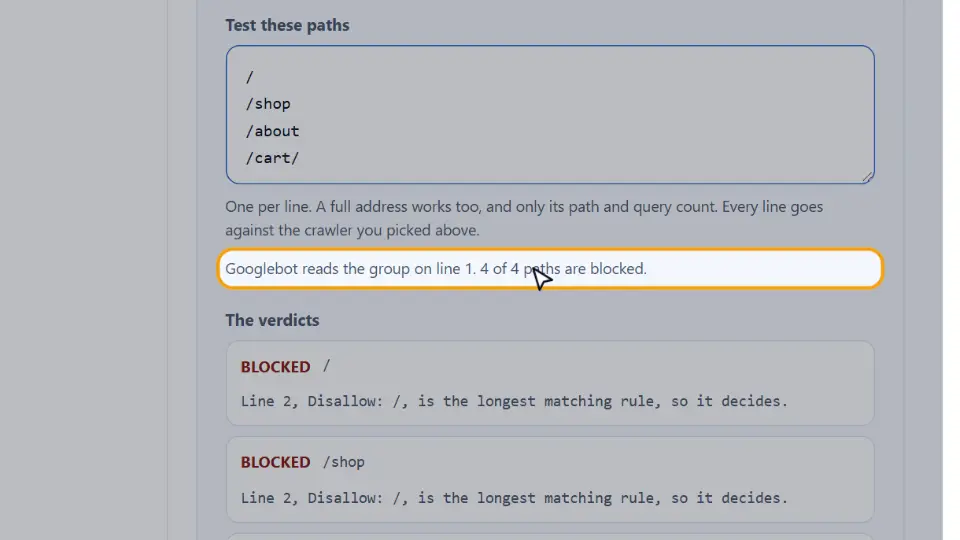
Provare il robots.txt prima di metterlo online.
Una modifica al file robots.txt vale appena la salvi, e Google può leggerla in poche ore. Quindi testa ogni modifica prima. Ci vuole un minuto e risparmi settimane di traffico perso.
Testa i percorsi che contano. Incolla il file nel nostro validatore robots.txt gratuito, poi elenca gli indirizzi chiave: la home, un prodotto, un articolo del blog e ogni cartella da bloccare. Per ciascuno lo strumento mostra Allowed o Blocked e indica la riga esatta che decide. Se una pagina utile risulta bloccata, vedi subito la regola colpevole.
Controlla ogni gruppo di crawler. Un file può avere gruppi separati per crawler diversi, come User-agent: Googlebot e User-agent: *. Ogni crawler obbedisce a un solo gruppo, quello che lo nomina più da vicino. Perciò, se aggiungi un gruppo per Googlebot, copia lì ogni regola che gli serve ancora, perché non legge più il gruppo con l’asterisco.
Dove deve stare il file. Il file funziona solo nella radice di un host, per esempio https://example.com/robots.txt. Una copia in una sottocartella non fa nulla. Inoltre ogni sottodominio ha bisogno del proprio file, e lo stesso vale per ogni protocollo. Google legge fino a 500 KiB del file e ignora il resto, quindi tienilo breve.
Cosa succede se il file non si carica. Se robots.txt restituisce un 404, Google considera il sito senza regole e scansiona tutto. Tuttavia, se il server restituisce un errore 5xx, Google mette in pausa la scansione, perché non può sapere cosa è consentito. Così un server guasto può sembrare un blocco del robots.txt. Per questo controlla anche il codice di stato con il nostro HTTP Header Checker.
Errori comuni
- Tenere
Disallow: /di un sito di prova dopo il lancio. - Chiudere le cartelle CSS e JavaScript, così Googlebot vede un layout rotto.
- Usare robots.txt per nascondere una pagina che dovrebbe avere noindex.
- Dimenticare la barra finale, quindi
Disallow: /blogblocca anche /blog-tips/. - Mettere robots.txt in una sottocartella; funziona solo nella radice.
In breve: trova la riga che blocca, blocca solo il privato e chiedi una nuova scansione. Per ogni regola nel dettaglio leggi la guida di Google su robots.txt.
Domande e risposte
Cosa significa bloccata da robots.txt?
Il file robots.txt chiede a Google di non scansionare quelle pagine, quindi non può leggerle e quasi mai le mostra.
Come sistemo le pagine bloccate da robots.txt?
Trova la riga Disallow che le riguarda, toglila o restringila, salva il file e poi fai clic su Convalida correzione in Search Console.
Dov’è il mio file robots.txt?
Nella radice del dominio, per esempio https://example.com/robots.txt. Le sottocartelle non contano.
Come provo il mio robots.txt?
Incollalo nel nostro Robots.txt Validator gratuito e prova gli indirizzi importanti. Così vedi quale regola consente o blocca ciascuno.
Una regola nel robots.txt basta a togliere una pagina da Google?
No, perché ferma la scansione, non l’indicizzazione. Usa un tag noindex e lascia che Google scansioni la pagina.
Perché Google indicizza una pagina bloccata da robots.txt?
Perché altri siti la collegano e Google conosce l’indirizzo. La mostra senza descrizione, perché non può leggere la pagina.
Cosa fa Disallow: /?
Blocca tutto il sito per i crawler di quel gruppo. Su un sito online è quasi sempre un errore.
Che robots.txt va bene per WordPress?
Blocca /wp-admin/, consenti /wp-admin/admin-ajax.php e aggiungi la riga della sitemap. Inoltre non bloccare CSS né JavaScript.
Devo bloccare CSS e JavaScript?
No, perché Google ne ha bisogno per mostrare la pagina e valutarne layout e versione mobile.
Quanto ci mette Google a scansionare di nuovo?
Spesso pochi giorni. La convalida in Search Console può richiedere qualche settimana con molte pagine.
Cos’è la direttiva Allow?
Permette a un crawler di raggiungere un percorso dentro una cartella bloccata. Vince la regola più specifica.
Posso bloccare i crawler di IA in robots.txt?
Sì, indicando il loro user agent, come GPTBot, con Disallow: /. I crawler seri lo rispettano.
robots.txt protegge i file privati?
No, perché è pubblico ed è solo una richiesta. Quindi proteggi i file privati con una password.
Cos’è la riga Sitemap in robots.txt?
Una riga come Sitemap: https://example.com/sitemap.xml che indica ai crawler dove si trova la sitemap.
L’opzione di WordPress che scoraggia i motori tocca robots.txt?
Sì, perché aggiunge un segnale noindex e può cambiare il robots.txt virtuale. Disattivala dopo il lancio.
robots.txt distingue maiuscole e minuscole?
Nei percorsi sì. Disallow: /Blog/ non blocca /blog/, quindi rispetta le maiuscole dei tuoi URL.
Cosa succede senza robots.txt?
I crawler considerano tutto il sito consentito. Per quasi tutti i siti piccoli va bene così.
Un robots.txt sbagliato può far scendere il ranking?
Sì. Se blocca pagine importanti, Google non può leggerle e col tempo escono dai risultati.
Come creo un file robots.txt?
Usa il nostro Robots.txt Generator gratuito e poi carica il file nella radice del sito.
Il SEO Checker legge robots.txt?
Sì. Il nostro SEO Checker mostra il tuo robots.txt e avvisa quando blocca la pagina che provi.
robots.txt nasconde una pagina alle persone?
No. Chiunque può aprire la pagina con il suo indirizzo, e chiunque può leggere il tuo file robots.txt. Quindi non usarlo mai per nascondere pagine private. Mettile invece dietro un accesso.
Posso bloccare i crawler di IA con robots.txt?
Sì, quelli che rispettano le regole. Aggiungi un gruppo per ciascuno, come User-agent: GPTBot con Disallow: /. Tuttavia un crawler che ignora robots.txt non verrà fermato.
Devo bloccare i file CSS e JavaScript?
No. Google mostra le pagine come un browser, quindi gli servono CSS e script per vedere il layout. Bloccarli può far sembrare la pagina rotta a Google e peggiorarne il posizionamento.
Quanto ci mette Google a notare una modifica al robots.txt?
Google di solito tiene il file in cache fino a un giorno. Perciò una correzione può richiedere un giorno per valere. Dopo, la scansione delle pagine sbloccate riprende al ritmo normale.
Il file robots.txt è obbligatorio?
No. Senza file, i crawler visitano semplicemente ogni pagina che trovano. Tuttavia un file breve con una riga Sitemap li aiuta a trovare le pagine, ed evita errori 404 nei log.