Trouver le CSS inutilisé
Un outil pour repérer les règles mortes
Cet outil trouve le CSS inutilisé en vérifiant chaque règle de votre feuille de style. Ensuite, il compare chaque règle à vos vraies pages et à vos scripts. Ainsi, vous voyez ce qu’aucune page n’utilise, et vous obtenez un fichier propre. De plus, tout se passe dans votre navigateur, et nous ne gardons rien.
- GratuitPrix
- TroisEntrées
- AucuneInscription
- RienStocké
Trouver le CSS inutilisé
Trouvez les règles qu’aucune page n’utilise, puis téléchargez la feuille sans elles
Une page ou plusieurs : commencez chaque nouvelle page par une ligne qui dit <!-- page -->.
La feuille de style à vérifier. Les blocs style dans le HTML sont lus aussi.
Ajoutez votre JavaScript (facultatif, mais le résultat est plus sûr)
L’outil garde et signale les classes qu’un script ajoute plus tard, comme is-open, donc il ne les dit jamais inutilisées.
Ce site récupère la page, ses feuilles de style et ses propres scripts pour vous. Aucun navigateur ne peut lire un autre site directement. Ensuite, la vérification se fait ici, dans votre onglet.
Options
Un par ligne ou séparés par des virgules : un nom de classe, un nom avec * (btn-*) ou un motif entre barres obliques (/^is-/).
Prêt. Ajoutez votre HTML et votre CSS, puis appuyez sur Trouver le CSS inutilisé.
- Règles inutilisées
- —
- Sélecteurs retirés
- —
- Taille gagnée
- —
- Gardées pour les scripts
- —
Ce que fait un outil de CSS inutilisé
Les feuilles de style grossissent toujours. Vous ajoutez des fonctions et changez le design, et le vieux code reste. Par conséquent, chaque visiteur télécharge des styles pour des parties du site qui ne s’affichent plus.
Un outil de CSS inutilisé répond à une question. Quelles règles peuvent partir sans changer l’aspect d’aucune page ? Donc celui-ci lit votre HTML, votre CSS et votre JavaScript. Ensuite, il range chaque règle dans l’un de quatre groupes.
Les groupes sont faciles à lire. D’abord, les règles que rien n’utilise. Ensuite, les règles dont seuls certains sélecteurs correspondent. Puis, les règles gardées car un script pourrait en avoir besoin. Enfin, les règles que vos pages utilisent maintenant.
Le résultat est un plan, pas un pari. Chaque règle a sa raison, donc vous pouvez la vérifier avant de supprimer quoi que ce soit. Ensuite, vous téléchargez la feuille propre en une seule étape.
Comment cet outil lit votre code pour trouver le CSS inutilisé
Le travail se fait en trois passes. D’abord, la page transforme votre HTML en arbre d’éléments, chacun avec sa classe, son id et ses attributs. Ensuite, elle lit votre CSS et sépare chaque liste de sélecteurs en sélecteurs simples. Enfin, elle teste chaque sélecteur sur chaque élément.

Votre navigateur fait tout cela. Comme ce site bloque les façons dangereuses de lire le balisage, l’outil utilise son propre lecteur. Donc il n’exécute jamais le code collé, et un script collé ne fait rien.
La comparaison suit les vraies règles de CSS. Par exemple, une espace veut dire descendant, et un signe supérieur veut dire enfant. De plus, :nth-child compte les frères comme un navigateur. Ainsi, quand un sélecteur rate votre balisage, le rapport le dit.
Trouver le CSS inutilisé sur plusieurs pages
Une page montre rarement tout. Par exemple, une règle du paiement semble morte sur l’accueil, pourtant le paiement en a besoin. C’est pourquoi cet outil prend toutes les pages que vous lui donnez.
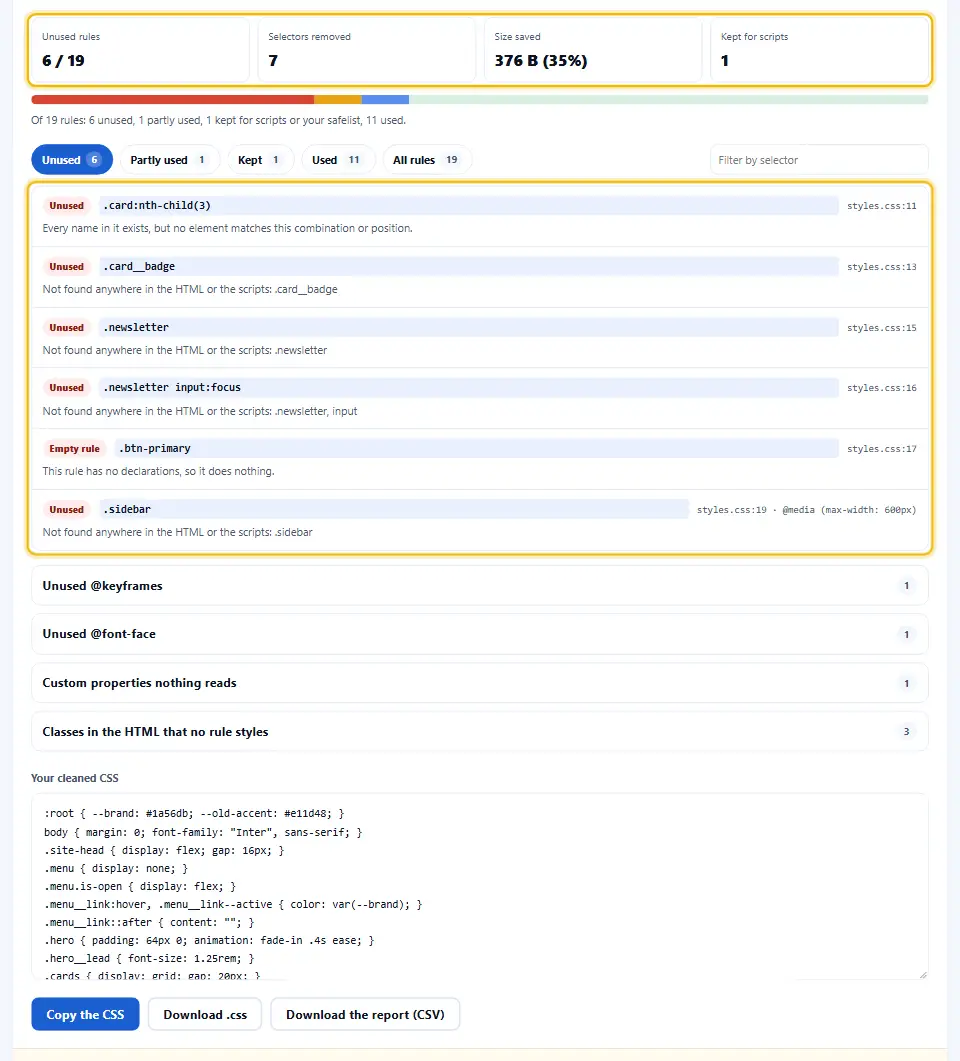
Vous pouvez coller plusieurs pages dans une seule zone. Il suffit de commencer chaque nouvelle page par une ligne de commentaire qui dit page. Ou importez vos fichiers HTML, et chaque fichier compte comme une page.
Chaque règle utilisée dit aussi où elle vit. Par exemple, utilisée sur 2 pages sur 5 vous dit qu’un style appartient à un modèle. Ainsi, cet indice aide quand vous divisez plus tard une grande feuille en plus petites.
Pourquoi une seule page ne suffit pas
La plupart des sites partagent une feuille entre de nombreux modèles. Donc si vous testez une seule page, environ la moitié du fichier semble inutilisée, ce qui est faux. Mais ajoutez une fiche produit, un article de blog et un formulaire de contact, et le vrai poids mort apparaît.
La règle est simple. Ajoutez une page de chaque type de votre site, car l’outil ne peut juger que les pages qu’il voit.
Les classes que votre JavaScript ajoute plus tard
Les menus s’ouvrent, les onglets changent et des fenêtres apparaissent. Chaque fois, un script ajoute une classe, donc la classe n’est pas dans le HTML au départ. Par conséquent, un outil négligent dit ces règles inutilisées, et les supprimer casse le menu.
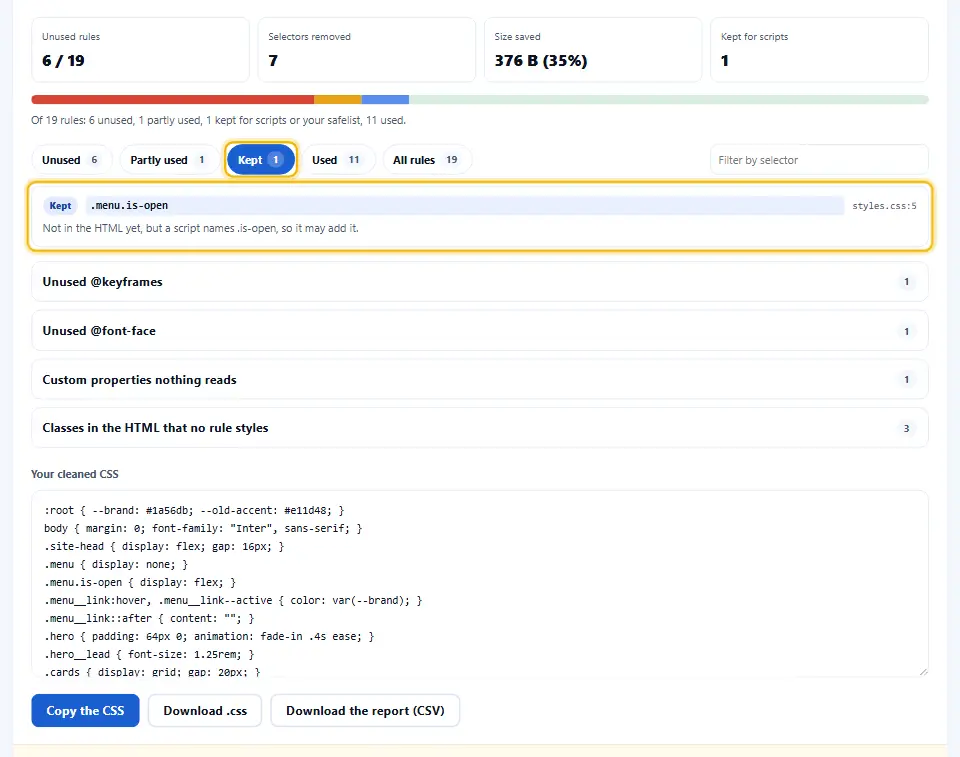
Cet outil lit aussi vos scripts. Il collecte chaque chaîne qu’ils contiennent, même les morceaux des gabarits de texte. Donc si un script cite is-open, la règle .menu.is-open reste, avec une étiquette au lieu d’une suppression.
Les préfixes comptent aussi. Par exemple, un script qui construit btn--${state} peut créer toute classe qui commence par btn--. Ainsi, chaque règle pour ces classes reste, et l’étiquette explique pourquoi.
Les liaisons des frameworks reçoivent le même soin. L’outil lit les attributs de classe de Vue, Alpine et Angular, plus les attributs data et les événements en ligne. En bref, il couvre les sources habituelles de classes cachées.
La liste protégée pour tout le reste
Certaines classes viennent d’endroits qu’aucun outil ne lit. Par exemple, une extension peut les ajouter sur le serveur, ou un rédacteur peut les taper à la main. Pour celles-là, utilisez la liste protégée.
Chaque ligne accepte un nom de classe, un nom avec une étoile ou un motif entre barres obliques. Ainsi, wp-* garde toutes les classes WordPress. De plus, un motif comme /^is-/ garde toutes les classes d’état d’un coup.
Pseudo-classes, pseudo-éléments et états
Beaucoup d’outils de CSS inutilisé se trompent justement ici. Ils cherchent .card::after ou .menu summary::before, ne trouvent pas cet élément et déclarent la règle morte. Or un pseudo-element met en forme une partie de son élément. Donc la règle compte comme utilisée dès que l’élément existe.
Les états marchent pareil. Quand une page se charge, personne n’a encore survolé, ciblé ni coché quoi que ce soit. Cependant, les visiteurs survolent et cliquent vite. Donc :hover, :focus et :checked comptent ici comme atteignables.
La structure compte quand même. Par exemple, li:nth-child(4) dans une liste de trois éléments ne correspond jamais, car aucun clic n’ajoute un quatrième élément. En bref, l’outil garde seulement ce qui pourrait vraiment correspondre.
Supprimer le CSS inutilisé en gardant votre mise en forme
Trouver les règles mortes n’est que la moitié du travail. L’autre moitié, c’est un fichier propre à publier. Donc cet outil coupe les règles mortes dans votre propre texte. Il ne reconstruit pas votre feuille de style.
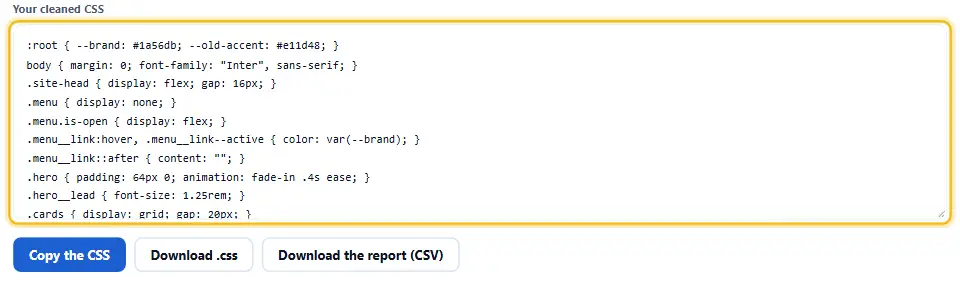
Vos commentaires, vos espaces et votre ordre restent. Quand seule une partie d’une liste de sélecteurs est morte, seule cette partie part. De plus, l’outil retire les media queries vides.
Vous choisissez la forme du résultat. Gardez-le lisible pour votre projet, ou cochez minifier pour une copie plus petite. Ensuite, copiez-le, ou téléchargez-le à côté du rapport CSV.
@keyframes, polices et variables mortes
Les règles ne sont pas le seul poids mort. Une animation inutilisée, une police inutilisée et une propriété personnalisée que personne ne lit coûtent aussi des octets. Donc l’outil liste chacune sous son propre titre.
Cette vérification se fait une fois les règles mortes parties. Par conséquent, l’outil marque aussi une police comme inutilisée si seule une règle supprimée l’utilisait. Une simple recherche de texte le raterait.
Il repère aussi l’erreur inverse. Si une règle lit une propriété personnalisée que rien ne définit, l’outil la liste. En général, cela signale une faute de frappe ou un fichier manquant.
Récupérer une vraie page par son adresse
Parfois, vous n’avez que l’adresse web. Dans ce cas, tapez-la, et ce site récupère la page, ses feuilles de style et ses propres scripts. Ensuite, la vérification se fait dans votre navigateur comme d’habitude.
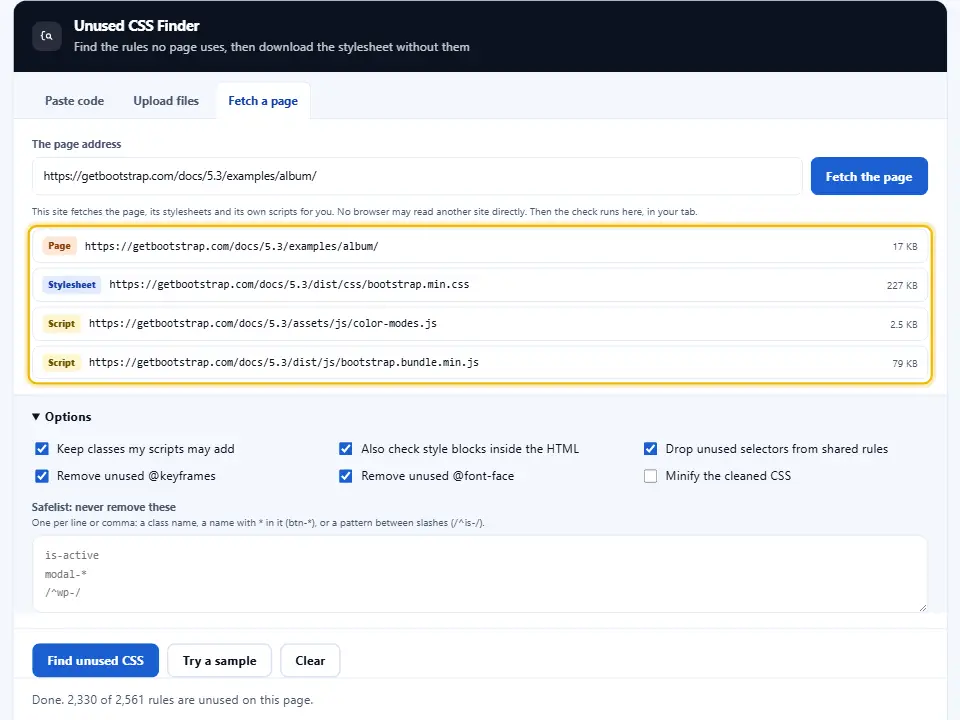
La récupération est prudente. Elle suit un niveau de @import, ignore les scripts d’autres sites et s’arrête à une taille sûre. Ainsi, un gestionnaire de balises ou un chat ne vous fait pas perdre de temps.
Ce mode convient pour un coup d’œil rapide sur un site qui n’est pas le vôtre. Cependant, pour votre propre projet, collez ou importez les fichiers source. Ainsi, vous ajoutez tous les modèles d’un coup.
Ce que l’outil ne peut pas savoir
Aucune vérification statique ne voit tout. Par exemple, une classe issue d’une valeur du serveur, ou un balisage chargé plus tard par un script, reste caché. C’est pourquoi chaque suppression a une raison que vous pouvez lire avant.
Donc traitez le résultat comme une revue de code. Vérifiez la liste, protégez ce dont vous avez besoin et testez le fichier propre sur une copie de préproduction. Pour un deuxième avis, le Coverage panel in Chrome DevTools montre ce qu’une visite a utilisé.
Sur cette page
- L’outil
- Ce que fait un outil de CSS inutilisé
- Trouver le CSS inutilisé, étape par étape
- Ce que cet outil de CSS inutilisé fait autrement
- Supprimer le CSS inutilisé sans casser une page
- Erreurs fréquentes quand on supprime le CSS inutilisé
- FAQ sur le CSS inutilisé
- Des compagnons utiles pour vos feuilles de style
Continuer
Comment trouver le CSS inutilisé
Une courte vidéo montre chaque étape. Ensuite, choisissez votre langue ci-dessous et activez les sous-titres si vous le souhaitez.
Trouver le CSS inutilisé, étape par étape
Quatre étapes vous mènent d’une feuille lourde à une feuille légère.
- 1
Ajoutez vos pages
Collez le HTML, importez les fichiers ou tapez l’adresse d’une page.
- 2
Ajoutez le CSS et les scripts
L’outil vérifie la feuille, et vos scripts protègent les classes qu’ils ajoutent.
- 3
Lisez les verdicts
Chaque règle montre son groupe et sa raison, donc rien n’est deviné.
- 4
Prenez le fichier propre
Copiez le résultat ou téléchargez-le, puis testez-le sur une copie de préproduction.
Ce que cet outil de CSS inutilisé fait autrement
Des verdicts sûrs, de vraies raisons et un fichier propre qui vous ressemble encore.
Il lit vos scripts
L’outil garde les classes qu’un script ajoute plus tard, et les signale.
Il comprend les pseudo-éléments
Une règle ::before compte comme utilisée dès que son élément existe.
Il vérifie plusieurs pages
Ajoutez chaque modèle, et chaque règle dit combien de pages l’utilisent.
Il explique chaque verdict
Chaque règle nomme la classe ou la structure qui l’a rendue morte.
Il garde votre mise en forme
Les règles mortes sont coupées de votre propre texte, et les commentaires restent.
Il reste dans votre navigateur
Le code collé ou importé ne quitte jamais l’onglet que vous utilisez.
Supprimer le CSS inutilisé sans casser une page
Quelques habitudes transforment un nettoyage risqué en routine.
- Donnez-lui chaque modèle Une page de chaque type donne à l’outil une vue complète de votre site.
- Ajoutez toujours les scripts Sans eux, les classes d’état semblent mortes alors qu’un clic les ajoute.
- Protégez ce qui vient du serveur Les classes des extensions et des éditeurs n’apparaissent jamais dans un modèle, donc nommez-les une fois.
- Testez avant de publier Mettez le fichier propre sur une copie de préproduction et parcourez d’abord les pages.
Erreurs fréquentes quand on supprime le CSS inutilisé
Chacune supprime une règle dont un vrai visiteur a encore besoin.
Vérifier seulement l’accueil
Les règles des pages internes semblent mortes si l’outil ne voit jamais ces pages.
Oublier les scripts
Les menus ouverts et les onglets actifs dépendent de classes qu’ajoute seulement un script.
Faire confiance à un outil qui ignore ::before
Les icônes et décorations disparaissent quand leurs règles de pseudo-élément partent.
Oublier l’impression et le mode sombre
Les règles de media query s’appliquent dans des cas qu’une vérification rapide regarde rarement.
Publier sans tester
Un fichier propre est un changement comme un autre, donc il mérite un passage en préproduction.
FAQ sur le CSS inutilisé
Que fait un outil qui trouve le CSS inutilisé ?
Il compare une feuille de style aux pages qui l’utilisent. Ensuite, il liste chaque règle qu’aucun élément ne touche. Ainsi, vous supprimez les styles morts, avec une raison claire pour chacun.
Cet outil est-il payant ?
Non. Il est gratuit, sans compte, et vous pouvez l’utiliser autant de fois que vous voulez.
Mon code quitte-t-il mon navigateur ?
Pas si vous le collez ou l’importez. Toute la vérification se fait dans votre onglet. Seul le mode récupération envoie l’adresse saisie à ce site, et nous ne gardons rien.
Comment trouver le CSS inutilisé sur tout un site ?
Ajoutez une page de chaque modèle, plus les feuilles de style et les scripts partagés. Comme l’outil voit toutes les pages ensemble, toute règle utilisée sur une page est gardée.
Pourquoi l’outil garde-t-il certaines règles ?
Parce qu’un script ou votre liste protégée nomme la classe dont elles ont besoin. Un script peut ajouter cette classe après le chargement. Donc, supprimer la règle pourrait casser un menu ou une fenêtre.
Que veut dire en partie utilisée ?
La règle a une liste de sélecteurs, mais seuls certains correspondent. Donc l’outil retire les sélecteurs morts et garde la règle pour le reste.
Comprend-il :hover et :focus ?
Oui. Ces états comptent comme atteignables, car un visiteur peut survoler ou cliquer à tout moment. Seule la structure décide. Ainsi, une règle échoue seulement si aucun élément ne pourrait jamais correspondre.
Pourquoi d’autres outils signalent-ils les règles ::before ?
Parce qu’ils cherchent un élément nommé before, qui n’existe jamais. Or un pseudo-élément met en forme une partie de son élément. Donc ici, la règle compte comme utilisée dès que l’élément est là.
Peut-il lire les classes Tailwind ?
Oui. Les noms échappés comme md:flex ou w-1/2 fonctionnent bien. Cependant, un fichier d’utilitaires est énorme, donc un outil de build reste le meilleur endroit pour le nettoyer à chaque version.
Fonctionne-t-il avec React, Vue ou Svelte ?
En général, oui. Importez vos fichiers de composants, et l’outil lit les noms de classe dans leurs chaînes et liaisons. Cependant, les classes créées à partir de valeurs du serveur restent cachées, donc ajoutez-les à la liste protégée.
Que deviennent les règles @media ?
L’outil vérifie les règles à l’intérieur comme les autres. Si toutes les règles d’une media query sont mortes, tout le bloc disparaît. Sinon, les règles vivantes restent en place.
Supprime-t-il les @keyframes et les polices inutilisés ?
Oui, les deux par défaut. Vous pouvez décocher l’une ou l’autre option pour les garder. De plus, il liste les propriétés personnalisées sans jamais les supprimer, car un script pourrait encore s’en servir.
Le fichier propre garde-t-il mes commentaires ?
Oui. L’outil coupe les règles mortes dans votre propre texte, donc commentaires, espaces et ordre restent. Cochez minifier seulement si vous voulez une copie plus petite.
Puis-je vérifier une page par son adresse ?
Oui. Ouvrez l’onglet de récupération et tapez l’adresse. Ensuite, ce site télécharge la page, jusqu’à huit feuilles de style et les scripts propres au site. Puis la vérification se fait dans votre onglet.
Pourquoi le mode récupération a-t-il ignoré des scripts ?
Les scripts d’autres sites, comme les statistiques ou les chats, ajoutent rarement des classes à votre feuille de style. Donc l’outil les ignore et se concentre sur votre propre code.
Y a-t-il une limite de taille ?
Oui, environ six mégaoctets de code par passage. Pourtant, une grande feuille avec quelques pages prend moins d’une seconde sur un ordinateur portable normal.
Quelle différence avec Coverage de Chrome ?
Coverage montre ce qu’une visite a utilisé, dans un seul état du navigateur. Cet outil vérifie plusieurs pages à la fois, lit vos scripts et vous donne un fichier propre. Ainsi, les deux outils se complètent bien.
Peut-on supprimer sans risque tout ce qu’il liste ?
En général, mais testez d’abord. Une vérification statique ne voit pas les classes venues du serveur ou chargées plus tard. Donc un court test sur une copie de préproduction vaut toujours la peine.
À quoi sert la liste protégée ?
Elle protège les classes qu’aucun outil ne voit. Ajoutez un nom, un nom avec une étoile ou un motif entre barres obliques. Ensuite, chaque règle qui correspond est gardée.
Supprimer le CSS inutilisé accélère-t-il la page ?
Oui. Moins de CSS veut dire moins d’octets à télécharger et moins de travail avant l’affichage. D’ailleurs, Lighthouse le signale sous Réduisez les ressources CSS inutilisées.
Puis-je télécharger un rapport ?
Oui. Le CSV liste chaque sélecteur avec son groupe, son fichier, sa ligne, sa media query et sa raison. Ainsi, vous pouvez le partager avec votre équipe ou le joindre à un ticket.
Corrige-t-il le CSS invalide ?
Non. Un sélecteur qu’il ne peut pas lire est gardé, par prudence. Pour les fautes de grammaire, vérifiez d’abord la feuille avec le <a href="/css-validator/">CSS validator</a>.
Ai-je besoin d’un compte ?
Non. L’outil qui trouve le CSS inutilisé est gratuit, sans inscription, et ne garde rien quand vous fermez l’onglet.
Des compagnons utiles pour vos feuilles de style
Retirer les règles mortes est une étape. Ces trois outils couvrent les étapes autour.
Réduisez encore la feuille propre avant sa mise en ligne.
Ouvrir l’outil →Vérifiez ce qui reste avec la grammaire CSS, ligne par ligne.
Ouvrir l’outil →Voyez exactement quels éléments un sélecteur atteint.
Ouvrir l’outil →
Prêt à trouver votre CSS inutilisé ?
Ajoutez vos pages, votre feuille de style et vos scripts, puis lisez le verdict de chaque règle. De plus, l’outil est gratuit, sans compte, et votre code reste dans votre navigateur.